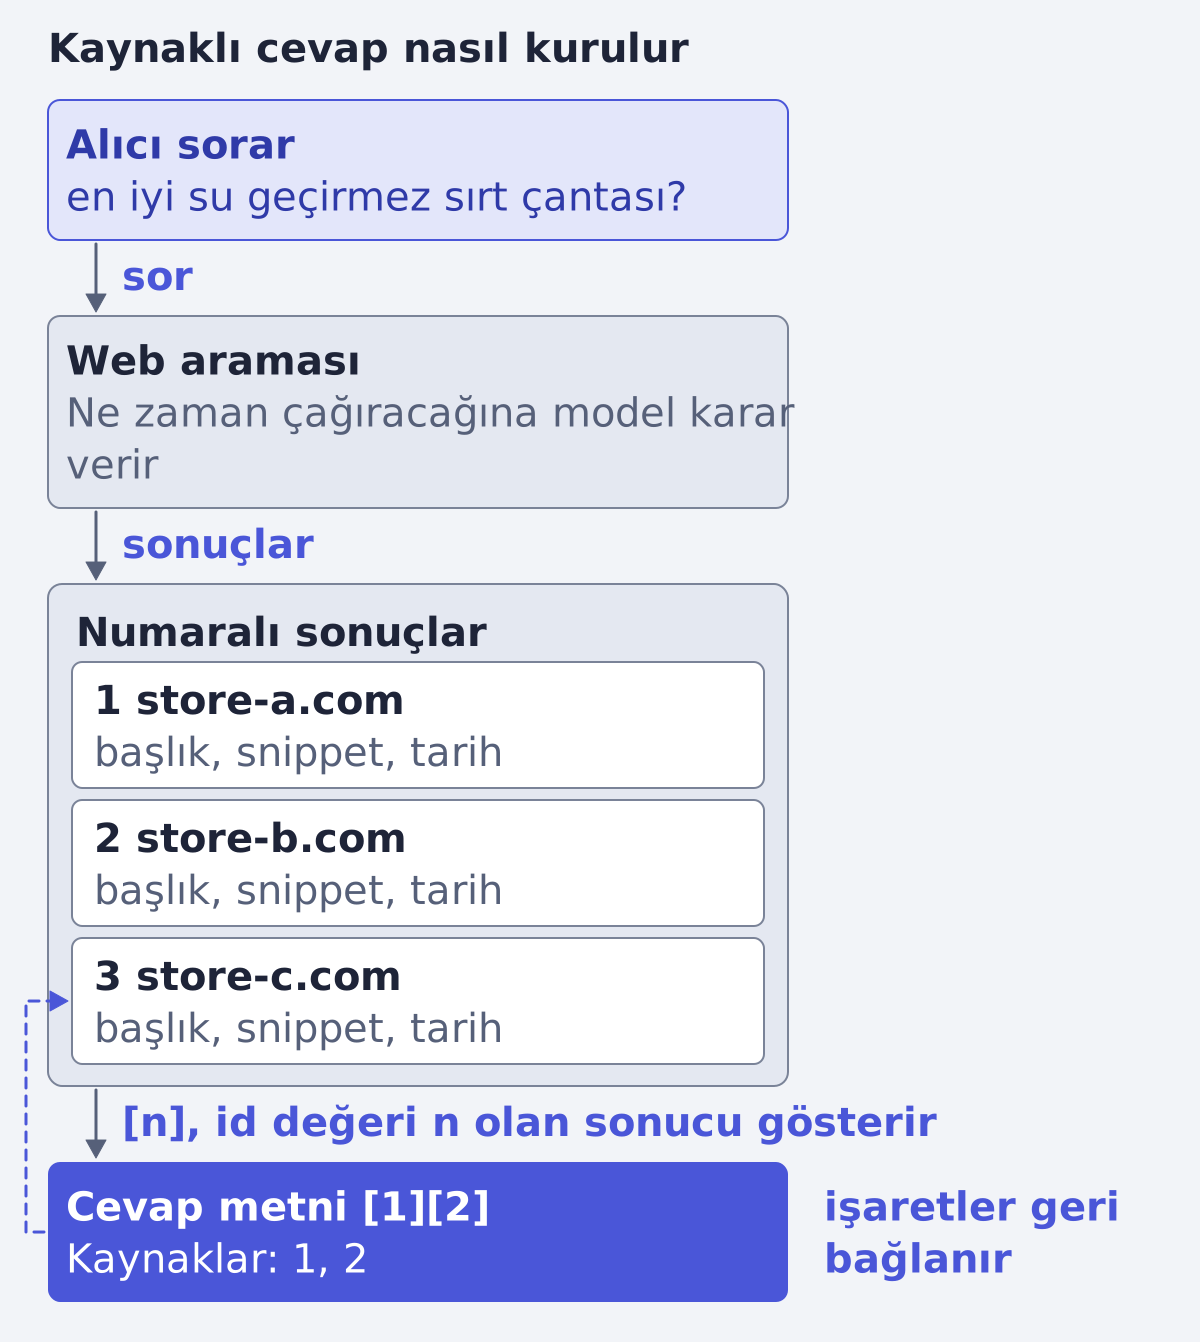
Perplexity'nin API'si kaynaklı bir cevabı iki adımda kurar: web araması sonuçlar getirir, sonra bir model cevabı yazar ve bu sonuçlara numarayla işaret eder (Web Search belgesi). Bir marka için işe yarayan kısım, belgelerin bir arama sonucunu neyin oluşturduğunu ve geliştiricinin onu dahil etmek ya da elemek için hangi denetimleri kullandığını göstermesidir.
Aşağıda Perplexity belgelerinden gelen her bilgi kendi sayfasına bağlıdır. Bir markanın ne yapması gerektiğine dair her söz bizim yorumumuzdur ve her seferinde bunu belirtiriz. Baştan bir sınır: bunlar geliştirici belgeleridir. API'yi anlatırlar, telefonunuzdaki Perplexity uygulamasını değil ve sonuçların nasıl sıralandığı hakkında hiçbir şey söylemezler.
Belgelerin anlattığı: iki yol, bir de kapanan yol
API platformunda tek anahtarın arkasında birkaç API var. Atıflar için ikisi önemli (platforma genel bakış):
- Search API:
title,url,dateve bir metinsnippetalanıyla JSON olarak sıralı web sonuçları. Model yok, üretilmiş cevap yok. - Agent API: atıflı, bitmiş bir cevap. Model
web_searcharacını kullanabilir.
Eski yol Sonar Chat Completions idi. Cevapları, [1][2][7] gibi işaretler taşıyan metnin yanında URL'lerden oluşan bir citations listesi ve nesnelerden oluşan bir search_results listesi taşırdı (Sonar hızlı başlangıç, eski). Belgeler şimdi Sonar Chat Completions desteğinin 27 Eylül 2026'da sona erdiğini, eşzamanlı ve akış istekleri Agent API isteklerine dönüştürülürken çalışmaya devam ettiğini söylüyor (geçiş genel bakışı). Bugün karşınıza çıkacak biçim Agent API'ninki, onu önce anlatıyoruz.
Bir cevap kaynaklarını nasıl bulur
Agent API'de web_search istekteki bir araçtır. Aracı ne zaman çağıracağına model, isteminize ve talimatlarınıza bakarak karar verir (Web Search belgesi). Belgelerin sıraladığı adımlar şöyle:
- Model bir ya da daha fazla arama yapar. Sorgu birkaç biçimde yeniden yazılırsa sonuç bütçesi sorgular arasında bölünür (Web Search belgesi).
- Yanıtta, son mesajdan önce bir
search_resultsöğesi bulunabilir. Her sonucun biriddeğeri vardır. - Cevap metni ayrı bir
messageöğesidir.[n]işaretleri bu metnin içindedir ve her biriiddeğerinolan sonuca karşılık gelir (geçiş rehberi).
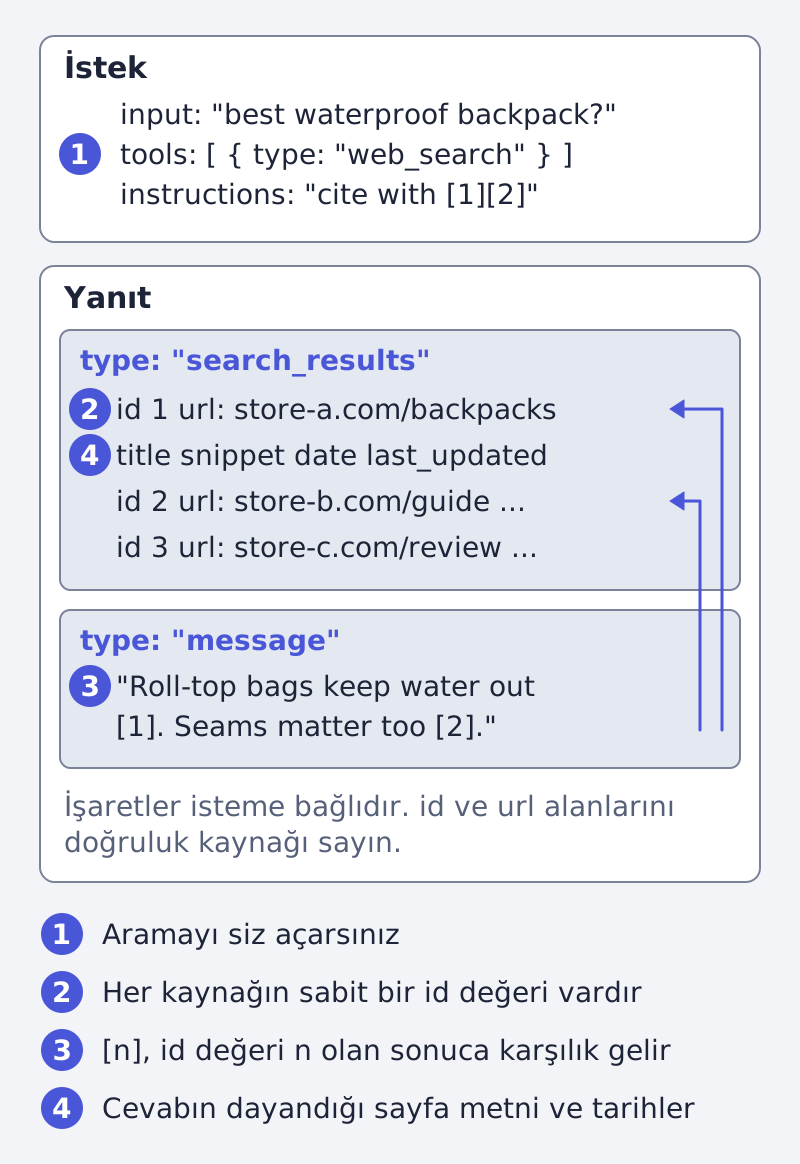
İki ayrıntı kolay gözden kaçar. Birincisi, işaretler garanti değildir: modelin işaret ekleyip eklemeyeceği "isteme bağlıdır" ve belgeler her kaydın id ile url alanlarını atıfların doğruluk kaynağı saymanızı söyler (Web Search belgesi). fast, low, medium ve high çaba seviyeleri satır içi atıfları zaten içerir: fast seviyesinde [1] gibi numaralı, diğerlerinde [web:1] gibi türü belirtilmiş (geçiş rehberi). İkincisi, fast seviyesinin yayımlanmış varsayılan talimatları modele arama bilgisi kullanan her cümleye atıf vermesini, cümle başına en fazla üç kaynak göstermesini ve arama yapmadıysa atıf koymamasını söyler (çaba seviyeleri). Bu talimatlara göre atıflı bir cümlenin, aramanın bulduğu bir sonuca dayanması beklenir (bu bizim yorumumuz; işaretlerin kendisi isteme bağlıdır).
Bir kaynak neye benzer
search_results içindeki her kaydın yedi alanı var (Web Search belgesi):
id: bir atfın işaret ettiği sabit sıra numarasıurl: kaynak sayfanın kanonik adresititle: sayfa başlığı, kaynağın verdiği haliylesnippet: arama sırasında sayfadan çıkarılan alıntı metindate: sayfanın ilk yayımlandığı tarih,YYYY-MM-DDbiçimindelast_updated: sayfanın son güncellendiği tarihsource: sonucun geldiği yer, meselaweb
Search API sayfası, snippet değerinin sorguyla ilgili ve bir token sınırında kesilmiş metin olduğunu, "boş bir dize olabileceğini" ekliyor; date ve last_updated de null olabilir (Search API genel bakışı). Belgeler, bir snippet'in neden boş geldiğini söylemiyor.
Geliştiricinin elindeki denetimler
API'yi çağıran biri, cevapların nereden geleceğini daraltabilir. Markaların nadiren gördüğü kısım budur.
| Denetim | Ne yapar | Sınır |
|---|---|---|
search_domain_filter |
Yalnızca listedeki alan adlarını ya da URL'leri alır, ya da başına - koyarak eler |
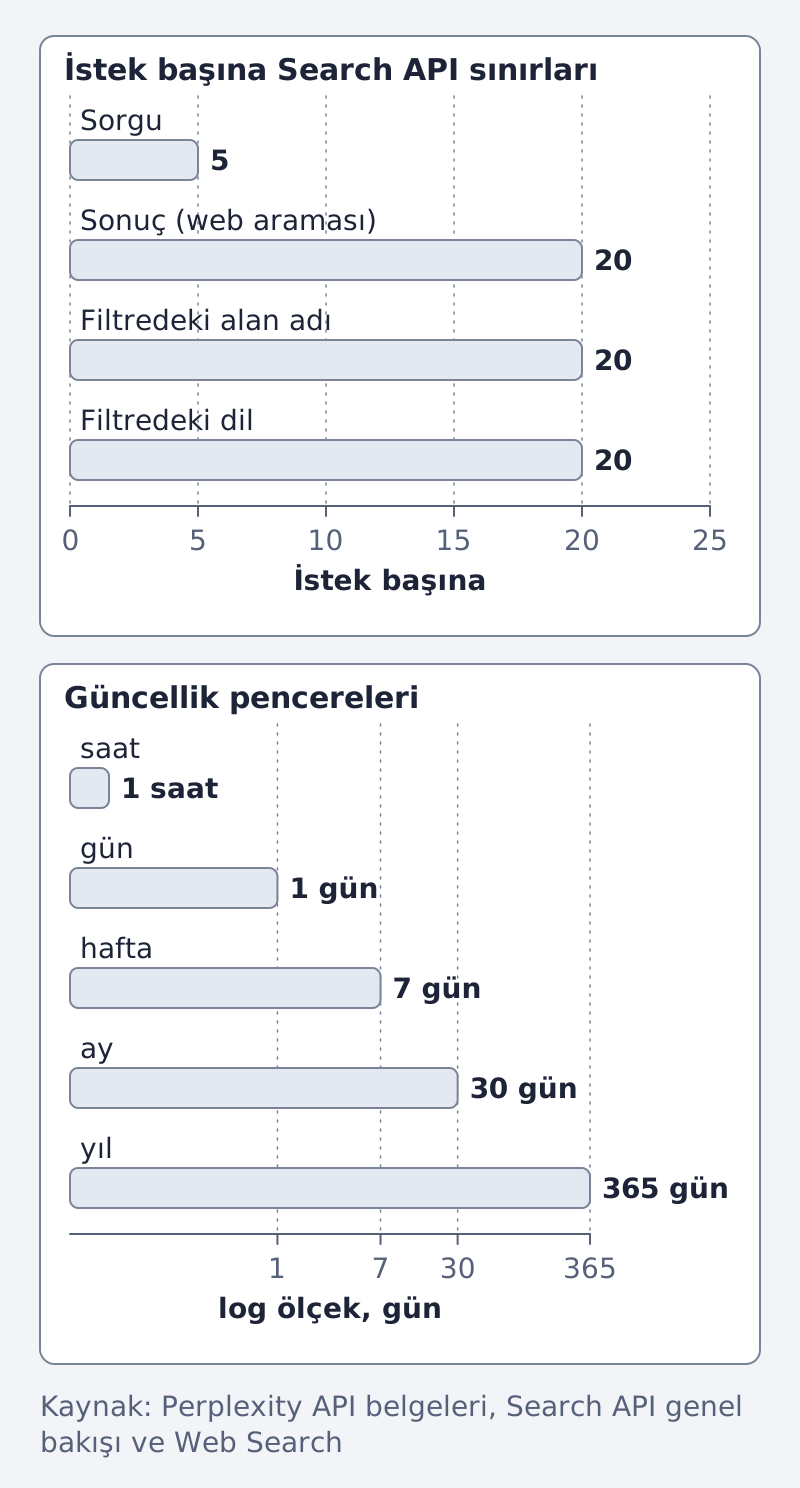
En fazla 20 kayıt, izin listesi ya da engel listesi, ikisi birden olmaz |
search_recency_filter |
Son hour, day, week, month ya da year içindeki sonuçları tutar |
Tek değer |
search_after_date_filter, search_before_date_filter |
Yayın tarihi bir aralığa düşen sonuçları tutar | MM/DD/YYYY |
last_updated_after_filter, last_updated_before_filter |
İlk yayına değil, son güncellemeye göre süzer | MM/DD/YYYY |
search_language_filter (Search API) |
Yalnızca listedeki dillerdeki sonuçları döndürür | En fazla 20 ISO 639-1 kodu |
user_location (Agent API) ya da country (Search API) |
Sonuçları bir ülkeye, bölgeye ya da şehre göre şekillendirir | Ülke iki harfli kodla |
max_results |
Bir çağrının topladığı sonuç sayısı | Agent API aracında 1 ila 50; Search API web aramasında 1 ila 20 |
Kaynaklar: Web Search belgesi, Search API genel bakışı, alan adı filtresi, tarih filtreleri, dil filtresi.
Alan adı filtresi alan adı düzeyinde (wikipedia.org) ya da URL düzeyinde çalışır; belgeler bir .gov kaydını da gösterir (Web Search belgesi). Güncellik pencereleri son bir saate, 24 saate, 7 güne, 30 güne ve 365 güne karşılık gelir.
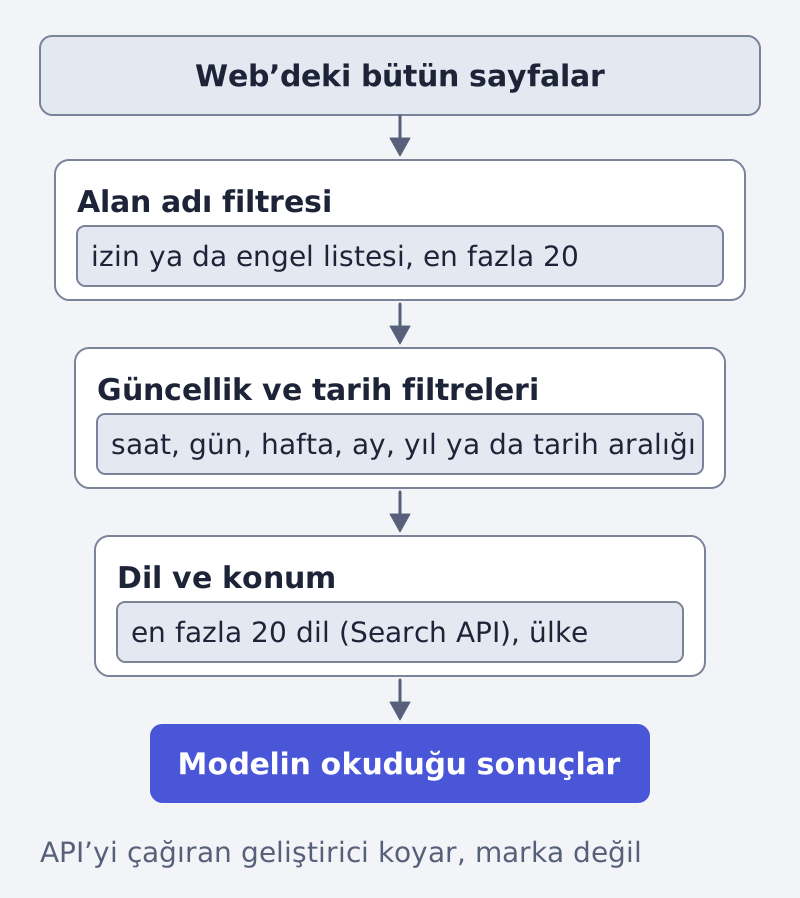
Filtreler birlikte kullanılabilir: belgeler, birleştirmelerine istek başına bir sınır olmadığını söylüyor (Web Search belgesi). Sınırların büyüklüğü okumaktan çok görerek anlaşılır.
Bir marka bundan ne öğrenir (bizim yorumumuz)
Belgeler bir markaya nasıl atıf alacağını anlatmaz. Orada bir sayfa göndermenin, yer satın almanın ya da dahil edilmeyi istemenin yolu yok. Gösterdikleri, çalışan mekanizmadır. Onu okuyunca beş sonuç çıkarırız ve hiçbiri Perplexity'nin verdiği bir söz değildir.
- Snippet için yazın.
snippet, sorgu için sayfadan çıkarılan metindir. Cevabını sayfanın üstünde açıkça söyleyen bir sayfa, bu çıkarıma malzeme verir. Perplexity'nin metni nasıl seçtiğini test etmedik. - Gerçek bir başlık koyun.
title, kaynağın verdiği haliyle döner ve okuyucunun işaretin yanında gördüğü şeydir. - Sayfaları dürüstçe tarihleyin ve güncelleyin.
datevelast_updatedbirer alandır, tarih ve güncellik filtreleri bunlara bakar. Belgeler,nulltarihli bir sayfanın filtre altında nasıl ele alındığını söylemiyor; buna güvenmeyin. - Tek soru için birkaç arama bekleyin. Model sorguyu yeniden yazabilir. Sayfada bir sorunun yakın söyleniş biçimlerini de karşılayın, yalnızca birini değil.
- Müşterinizin dilinde yayımlayın. Search API'de bir dil filtresi var; geliştirici Türkçe bir soruyu Türkçe sonuçlarla sınırlayabilir. Türkçe alıcının Türkçe bir sayfaya ihtiyacı var.
Ajanslar için pratik adım, tahmin etmek değil bakmaktır. Kategorinizin sorularını Search API'den ya da web_search içeren bir Agent API çağrısından geçirin; hangi url değerlerinin, hangi tarihlerle ve hangi snippet ile döndüğünü okuyun. Belgeler web_search için 1.000 çağrı başına 2,50 dolar, search_type: "fast" ile 1,00 dolar fiyat veriyor, model token'ları ayrıca (Web Search belgesi). Bunu yapan bir betik, Claude Code gibi bir araca uygun bir iştir. Asistanların tamamını görmek için ürünlerin yapay zeka cevaplarında nasıl göründüğüne bakın.
Bilmediğimiz şeyler
- Sonuçların nasıl sıralandığı. Search API sayfaları kendi sonuçlarına "sıralı" der ve orada durur.
- Perplexity uygulamasının API ile aynı ayarları kullanıp kullanmadığı. Belgeler API'yi anlatır ve Sonar içine yerleşik web aramasının artık
web_searcharacı olarak sunulduğunu söyler (geçiş rehberi). - Belirli bir sitenin ne sıklıkla atıf aldığı. Bu sayfalarda bunu anlatan bir rakam yok, o yüzden biz de vermiyoruz.
Atıf almak işin yarısı. Okuyucunun indiği sayfa ya da ardından gelen reklam da ayakta kalmalı: harcamadan önce bir reklamın kreatifini ücretsiz kreatif skoru ile kontrol edebilirsiniz. Ürünleriniz bir feed'de duruyorsa ve ondan bitmiş reklamlar istiyorsanız, Framepx'in işi budur: ürün feed'lerini reklama çeviren bir yapay zeka sistemi (nasıl çalışır).
Sık sorulanlar
Perplexity her zaman kaynak gösterir mi?
Kural olarak değil. Agent API'de işaretler isteme bağlıdır, ama fast, low, medium ve high çaba seviyeleri atıf talimatlarını varsayılan olarak içerir (geçiş rehberi). fast seviyesinin talimatları, arama yapılmadıysa atıf koyulmamasını söyler (çaba seviyeleri).
[1] en üstteki arama sonucu mudur?
Belgeler [n] işaretinin id değeri n olan sonuca karşılık geldiğini söyler. id 1'in en iyi sonuç olduğunu söylemez.
Sitemin atıf alması için ödeme yapabilir ya da başvurabilir miyim? Belgeler böyle bir seçenek anlatmıyor. Listelenen denetimler API'yi çağıran geliştiriciye aittir.
Atıf almanın yolu hala Sonar mı? Sonar Chat Completions desteği 27 Eylül 2026'da sona erdi ve belgeler tüm yeni projeler için Agent API'yi öneriyor (geçiş genel bakışı).
Kaynaklar
Yazan
Framepx ekibi, Editoryal ekip
Framepx editoryal ekibi; markalar, pazarlamacılar ve ajanslar için reklam platformları, ölçüm, kreatif ve ürün feed'i üzerine yazar.